Benchmark Baru PerceptionBench Ungkap Model AI Mapan Masih Lemah dalam Persepsi Visual
Moonshot AI, tim di balik asisten AI Kimi, memperkenalkan PerceptionBench, benchmark baru yang menguji kemampuan persepsi visual model bahasa multimodal dengan memisahkannya dari penalaran logis, dan hasilnya menunjukkan tidak ada satu pun model mapan yang mencapai akurasi 60 persen. GPT-5.6 Sol menduduki peringkat tertinggi dengan akurasi 59,7 persen, diikuti Kimi K3 58,5 persen, Claude Fable 5 57,2 persen, dan Gemini 3.1 Pro 56,2 persen, sedangkan model open-source seperti Qwen3.5-397B-A17B dan GLM-4.6V tertinggal jauh di angka 47,5 persen dan 32,5 persen.
Berbeda dengan metode pengujian standar yang menggabungkan persepsi, pengetahuan, dan penalaran dalam satu tugas, PerceptionBench memecah visi menjadi sepuluh sub-keterampilan atomik: Visual Relation, Counting, Attributes, Depth & 3D, Localization, Comparison, Fine-grained Recognition, Context Integration, OCR, dan Hallucination. Setiap pertanyaan dirancang agar bisa dijawab hanya dengan melihat gambar, tanpa memerlukan penalaran atau pengetahuan eksternal. Taksonomi ini dibangun dari kesalahan model nyata dengan menelusuri setiap kegagalan ke langkah paling awal di benchmark yang sudah ada.
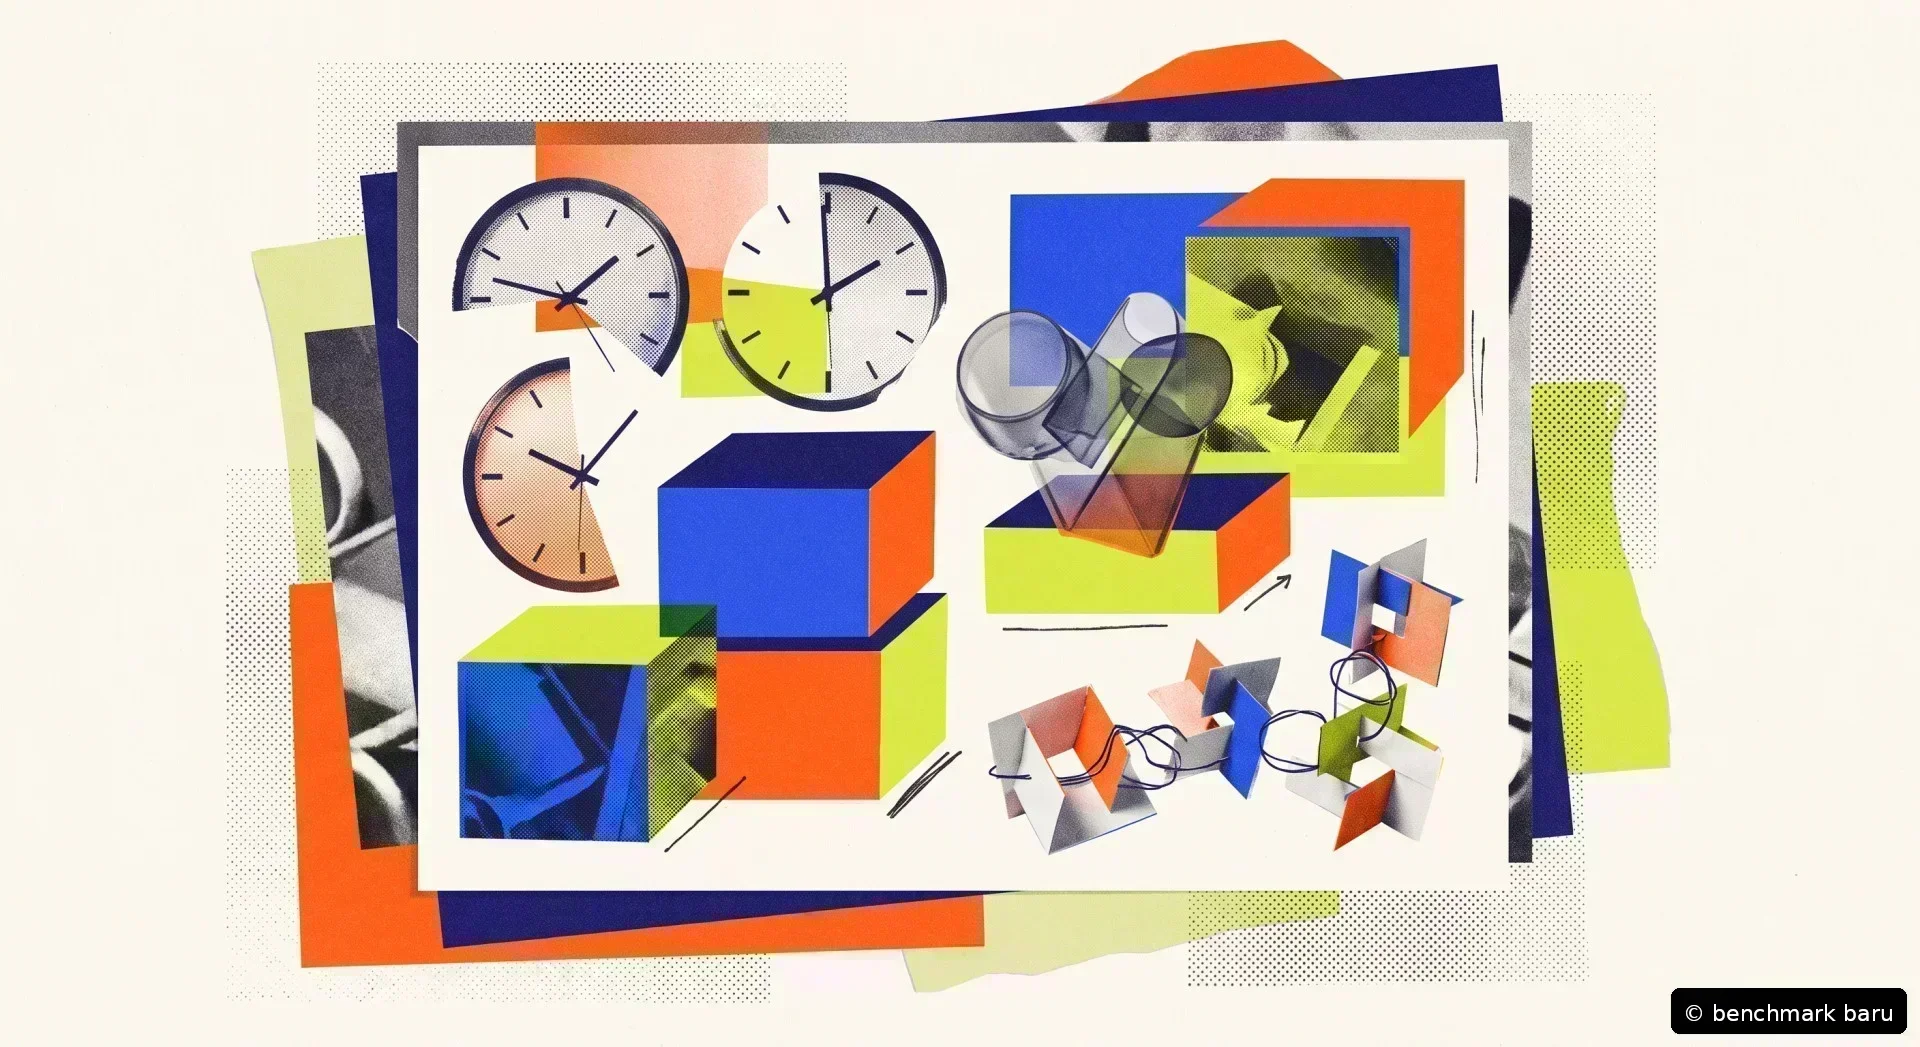
Dari kumpulan internal lebih dari 17.000 pertanyaan terverifikasi, Moonshot AI menerbitkan 3.000 tugas, di mana 60 persen diambil dari kesalahan model yang diatribusikan dan 40 persen direformulasi menggunakan gambar yang diaugmentasi. Tugas-tugas tersebut tampak sepele, seperti menentukan posisi simbol pada wajah jam, menghitung bunga di dalam kotak merah, atau membedakan dua gelas pensil dengan kombinasi warna abu-gula merah muda versus warna pink solid bergambar kartun.
Hasil tingkat kategori mengungkap detail yang lebih menarik dibandingkan peringkat keseluruhan. Model dengan skor agregat hampir identik menunjukkan perbedaan tajam di kategori individual. Secara rata-rata, 'hallucination' menjadi keterampilan terlemah di seluruh model. GPT-5.6 Sol yang memimpin klasemen keseluruhan hanya memperoleh 26,9 persen di kategori ini, sementara Gemini 3.5 Flash yang lebih lemah secara keseluruhan justru masuk peringkat terbaik dengan 50,6 persen.
Peneliti berargumen bahwa banyak kegagalan model multimodal yang biasanya dilabeli sebagai 'kesalahan penalaran' sebenarnya terjadi pada tingkat persepsi. PerceptionBench memecah pertanyaan-pertanyaan tersebut menjadi sub-pertanyaan hanya-persepsi, memungkinkan identifikasi kemampuan visual spesifik mana yang gagal. Dataset dan kode evaluasi tersedia di GitHub di repositori MoonshotAI/PerceptionBench.
Ini merupakan masalah yang sudah dikenal dengan sedikit kemajuan. Moonshot AI membangun Kimi K3 open-source yang telah menutup kesenjangan dengan Claude Fable 5 dan GPT-5.6 Sol hingga beberapa poin pada benchmark umum, meski masih tertinggal jauh di area khusus seperti keamanan siber ofensif dan matematika kompleks. Pada persepsi visual, K3 kini berkinerja setara dengan saingannya barat.
Tim peneliti yang sama sebelumnya merilis WorldVQA, benchmark yang memisahkan pengenalan objek dari penalaran, di mana model terbaik Gemini 3 Pro hanya mencapai 47,4 persen dan semua model secara sistematis melebihi estimasi kepercayaan diri mereka. Studi terpisah oleh institusi China dengan keterlibatan Moonshot AI menggunakan benchmark BabyVision menunjukkan model mapan gagal pada tugas visual dasar yang dikaitkan dengan perkembangan anak usia dini, seperti menelusuri garis atau menghitung balok tersembunyi. Gemini 3 Pro memperoleh 49,7 persen pada tugas tersebut, sedangkan manusia mencapai 94,1 persen. Peneliti mengaitkan kesenjangan ini dengan 'bottleneck verbalisasi' di mana informasi visual diterjemahkan ke dalam bahasa dan kehilangan fidelitas.


