Gemini vs Grok: Selisih Biaya per Tugas AI
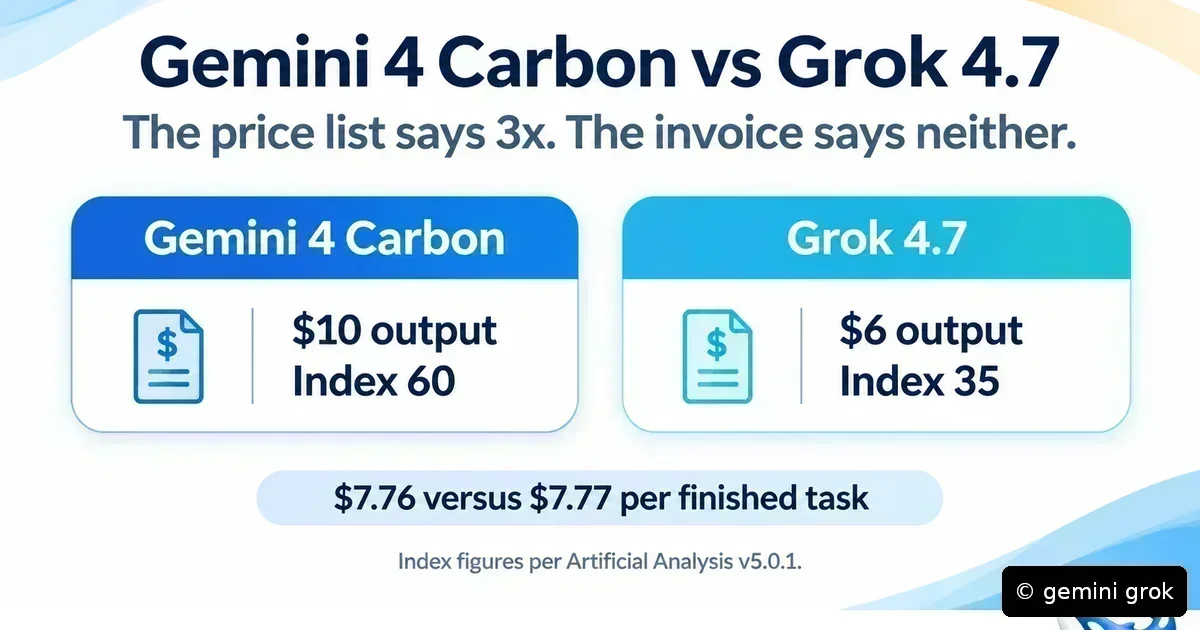
Kedua model AI terbaru, Gemini 4 Carbon dari Google dan Grok 4.7 dari xAI, dirilis secara berturut-turut pada September dan November 2026 namun menghasilkan biaya per tugas yang hampir identik, mengalahkan persepsi awal bahwa harga output yang lebih rendah otomatis menguntungkan pengguna. Perbandingan berbasis harga tertera versus biaya terukur per tugas oleh Artificial Analysis menunjukkan kesenjangan tipis senilai $7,76 untuk Carbon dan $7,77 untuk Grok 4.7 meskipun Google menetapkan harga output $10 per juta token versus $6 milik xAI, membuktikan bahwa skema pembanding konvensional sering menyesatkan ketika mengevaluasi model dengan profil kerja sangat berbeda dalam hal modalitas dan jendela konteks.
Spesifikasi dan Ketersediaan
Gemini 4 Carbon dapat diakses melalui Gemini API berbayar mulai 10 November 2026 dengan dukungan penuh multimodal mencakup teks, gambar, audio, video, dan PDF, sedangkan Grok 4.7 dirilis dua bulan sebelumnya pada 21 September 2026 hanya menerima teks, gambar, dan file saja. Struktur spesifikasi keduanya berbeda signifikan: Carbon menawarkan konteks 1.048.576 token dengan batas output sinkron 65.536 token serta dekode panjang hingga sekitar satu juta token, sementara Grok 4.7 membatasi konteks lima ratus ribu token namun menyediakan batas output tunggal mencapai empat ratus lima puluh ribu token. Perbedaan mendasar ini mencerminkan filosofi desain yang berbeda, di mana Carbon bertujuan menangani pipeline masukan komprehensif dengan sumber data heterogen, dan Grok dirancang untuk produksi output masif dari prompt terfokus tanpa kompleksitas multimoda.
Analisis Biaya dan Performansi
Secara struktur harga input keduanya identik senilai dua dolar per token dengan kenaikan proyeksi menjadi empat dolar, namun mekanisme caching menunjukkan perbedaan strategis yang krusial bagi pengembang skala besar. Caching input Carbon dibanderol $0,10 per juta kini dan akan naik menjadi $0,20 pada 1 Desember, sementara Grok 4.7 mematok $0,50 per juta dan meningkat menjadi $1 untuk prompt panjang, menjadikan Carbon lima kali lebih hemat untuk workload yang mengandalkan re-konfirmasi konteks berulang. Pada benchmark Artificial Analysis versi 5.0.1, Carbon mencetak skor indeks 60 dari pengaturan usaha tinggi menempati peringkat keempat dari 74 model, jauh melampaui Grok 4.7 yang hanya meraih 35 poin pada kategori usaha maksimum berada di peringkat kesebelas. Volume token keluaran Carbon tercatat 205 juta versus 148 juta milik Grok, waktu penyelesaian per tugas 25,6 menit dibanding 25,9 menit, kecepatan生成 80 token per detik lawannya 67 token, dan waktu tunggu ke token pertama 66,85 detik melawan 53,64 detik—semuanya masih berkali-kali lipat di atas median kelas harganya yang sebesar 12 detik, menandakan bahwa efisiensi absolut bukan pembeda utama di ranah premium ini.
Rekomendasi Penggunaan
Perbedaan selisih biaya per tugas yang sangat tipis muncul justru karena faktor verbositas buatan: Carbon mampu menghasilkan 39 persen lebih banyak token keluaran per pekerjaan meski harga satuan outputnya 67 persen lebih tinggi, sehingga perhitungan harga token Grok yang lebih murah secara keliru dianggap sebagai keunggulan kompetitif mutlak tanpa mempertimbangkan total tagihan riil. Kekuatan Grok 4.7 terletak pada kematangan operasional selama tujuh minggu penuh, kemampuan menghasilkan output panjang konsisten, dan ekonominya untuk beban kerja dengan input sedang sampai kecil serta output berat seperti peringkasan dokumen dan transformasi format—meskipun caching inputnya tetap lima kali lipat lebih mahal dibandingkan Carbon. Sebaliknya, Carbon unggul dalam dukungan modalitas lengkap termasuk audio dan video yang vital untuk pipeline Retrieval-Augmented Generation, performa keamanan siber yang dilaporkan Google mencatatkan Skor SEC-bench Pro 88,2 persen, ExploitGym 54,8 persen, dan CWE-bench 71,0 persen, serta jendela konteks satu juta token yang memungkinkan analisis menyeluruh seluruh repositori kode atau layanan skala enterprise dalam satu panggilan utuh.
Rekomendasi praktis membedakan pilihan berdasarkan karakteristik unik setiap use case: pilih Grok 4.7 jika kebutuhan utama adalah output panjang dari prompt terbatas atau jika stabilitas harga jangka pendek menjadi prioritas mengingat perubahan ketentuan akses Carbon dua kali dalam dua pekan terakhir; pilih Carbon untuk tugas dengan input multimoda, analisis kerentanan, atau pemrosesan konteks monorepo dengan ribuan file; dan jika masih sulit memutuskan, lakukan uji paralel dua minggu karena selisih biaya terukur hanyalah sekitar satu sen per tugas, menghasilkan jawaban yang lebih baik daripada mengandalkan skor komposit semata tanpa validasi empiris langsung di lingkungan production Anda sendiri.
Kesimpulan akhirnya menegaskan bahwa kesenjangan dua setengah poin indeks bukanlah ukuran kecerdasan mutlak melainkan cerminan fakta bahwa kedua model ini dirancang untuk tahapan berbeda dalam pipeline AI yang sama—Carbon memegang ujung masukan multimodal dan konteks luas, Grok menguasai ujung keluaran panjang—lalu dipasarkan dengan label generik yang sama sehingga perbandingan langsung sering kali menyesatkan pengambil keputusan yang mengira keduanya berkompetisi di arena identical padahal mereka melengkapi satu sama lain dalam ekosistem yang lebih besar.


